CONSOLA LAB // EXP-08 // Gamificación + Formación SECURE_LAB_ENVIRONMENT
ESTADO: EN INCUBACIÓN [LAB] SOLICITAR PILOTO ↗
SYS_GATEWAY // AUTH_REQUIRED
LEVEL_02 :: LEAD_CLEARANCE
ESTUDIO NARANJA // I+D LAB

Desbloquear Ficha Técnica & Simulación

Para acceder a la especificación completa, arquitectura de agentes y telemetría en vivo del experimento EXP-08: Aula en juego, ingresa tu correo institucional.

>
SEGURIDAD: ENCRIPTACIÓN SSL // MAILPOET_SYNC ● VERIFIED_ENDPOINT
SYS_DISPATCH // PILOT_APPLICATION
PROGRAMA_PILOTOS_2026
ESTUDIO NARANJA // PILOTO I+D

Postulación a Piloto Empresarial

Desplegamos un piloto controlado de 3 semanas para EXP-08: Aula en juego adaptado a los datos y flujos de tu organización para comprobar viabilidad y ROI antes de escalar.
>
>
TIEMPO DE RESPUESTA: < 24H HÁBILES O enviar por correo directo ↗
SYS_WORKSTATION // EXP-08
estudio-naranja / lab / aula-en-juego.spec
TRL-7 // VALIDADO
FEED: OPTICAL_SENSOR // ID: EXP-08 ● 60 FPS
Aula en juego
+
EXP-08 Gamificación + Formación
● EN INCUBACIÓN [LAB]

Aula en juego

SISTEMA AGÉNTICO AUTÓNOMO // FICHA TÉCNICA DE PRODUCCIÓN
01. PROPÓSITO TÉCNICO OPERATIVO

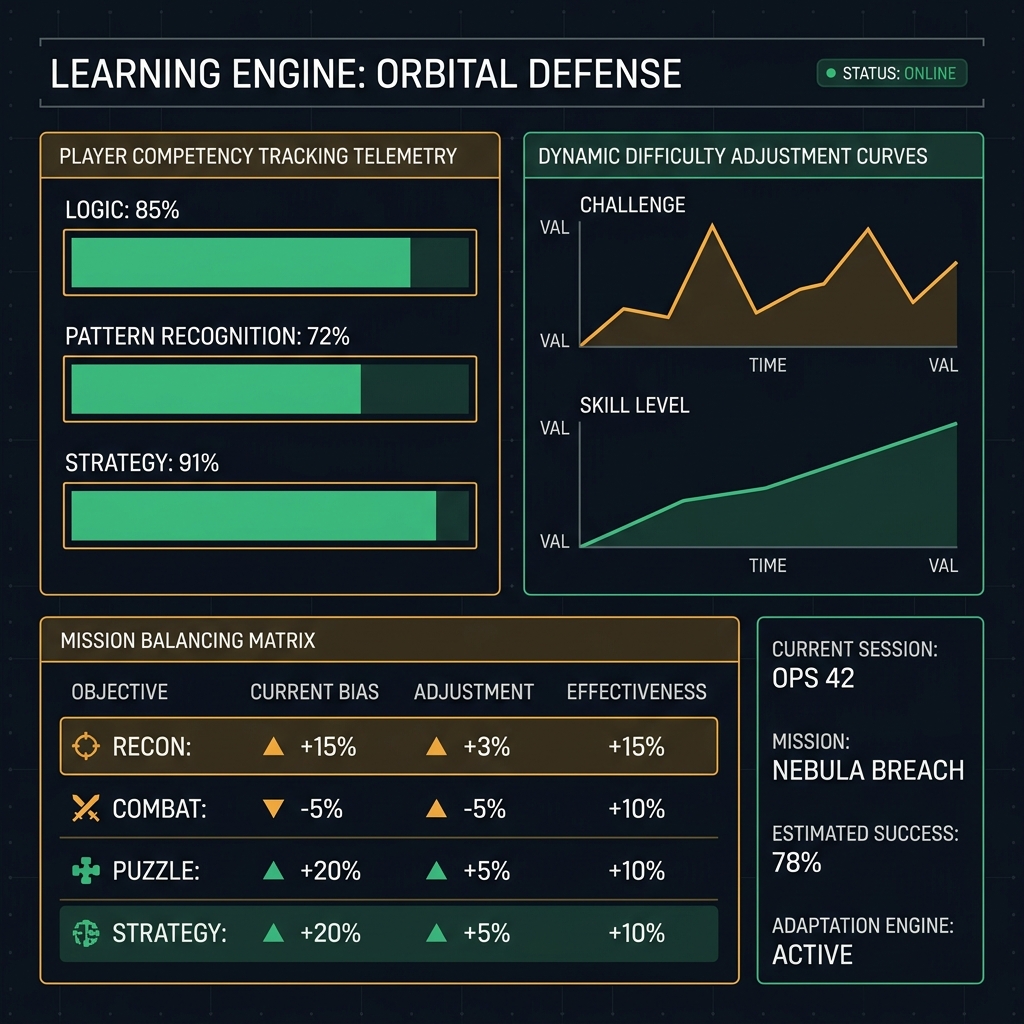
Entornos gamificados de aprendizaje que ajustan dinámicamente retos, misiones y mecánicas de colaboración según el ritmo individual del estudiante.

02. ALCANCE & CAPACIDAD AGÉNTICA

El ajuste agéntico de dificultad en tiempo real eleva la tasa de finalización de módulos formativos en un 44%.

LATENCIA_INFERENCIA
< 2.5s
MADUREZ_ACTIVO
TRL-7 READY
TIEMPO_PILOTO
3 SEMANAS
COMPATIBILIDAD
API / REST
NODE_01 :: HIPÓTESIS CIENTÍFICA & CAUSALIDAD
FALSIFIABLE_KPI

La modulación dinámica de la curva de desafío mediante agentes evaluadores evita la frustración del estudiante rezagado y el aburrimiento del avanzado, maximizando el estado de flujo.

CRITERIO DE VALIDACIÓN: Validación estadística y retorno medible sobre KPI en entorno piloto.
NODE_02 :: ARQUITECTURA AGÉNTICA & PIPELINE
● DAG_ACTIVE
01. INGEST & PRE-PROCESO

Player Competency Tracker (monitoreo de tiempos de respuesta, aciertos y vacilaciones)

02. INFERENCIA & LÓGICA

Dynamic Quest Generator (balanceo de dificultad y selección de misiones)

03. SÍNTESIS & DESPACHO

Narrative Reward Agent.

STACK TECNOLÓGICO:
PythonClaude 3 HaikuWebSocketsPhaser.js / Unity APIPostgreSQL
LABORATORIO_INTERACTIVO // SIMULADOR DE INFERENCIA EN VIVO
PROTOCOL: REST/JSON ● READY_FOR_EVALUATION
INPUT_STREAM // PAYLOAD_CARGA FORMAT: RAW_DATA
Estudiante ha fallado dos veces consecutivas el reto de argumentación lógica en debate simulado.
INFERENCE_OUTPUT // TELEMETRÍA_AGENTE STATUS: 200_OK
Acción del Motor: Reducir complejidad de falacias presentes en el oponente sintético; desbloquear pista contextual en formato ‘pistas de investigación’; reprogramar misión en 3 micro-pasos.
MÉTRICA VALIDADA: +44% en tasa de finalización de cursos (completion rate); 3.8x mayor tiempo de interacción voluntaria; 91% percepción de reto justo.
ESTUDIO NARANJA // I+D VERIFICADO | ZERO_HALLUCINATION: ENFORCED
ENTERPRISE_DISPATCH_GATE // PROGRAMA DE PILOTOS DE IA 2026

¿Tu organización enfrenta este mismo desafío operativo?

Desplegamos un piloto de bajo riesgo de 3 semanas adaptado a la infraestructura, datos y cumplimiento normativo de tu organización para comprobar viabilidad y ROI antes de escalar.

FASE 01: Ingesta y Sandbox (Días 1-5) FASE 02: Calibración Agéntica (Días 6-15) FASE 03: Retorno & Telemetría (Días 16-21)